وقتی یک داکیومنت فنی جدید رو برای یادگیری میخونیم، معمولاً به نکات جدید و جذاب برمیخوریم. من خودم برای ثبت این نکات از بخشهای مهم Screenshot میگرفتم.
اما بعد از مدتی با یک پوشه پر از Screenshot مواجه میشدم؛ تصاویری که شاید هرکدوم یک نکتهی مهم داخلشون بود، ولی پیدا کردن و مرور کردنشون سخت میشد.
اینجا بود که به این فکر افتادم:
چرا متن داخل این تصاویر رو بهصورت خودکار استخراج نکنیم و همه رو در یک فایل منظم نگه نداریم؟
از همین ایده، پروژهی TextGit شکل گرفت.
این ابزار چیکار میکنه؟
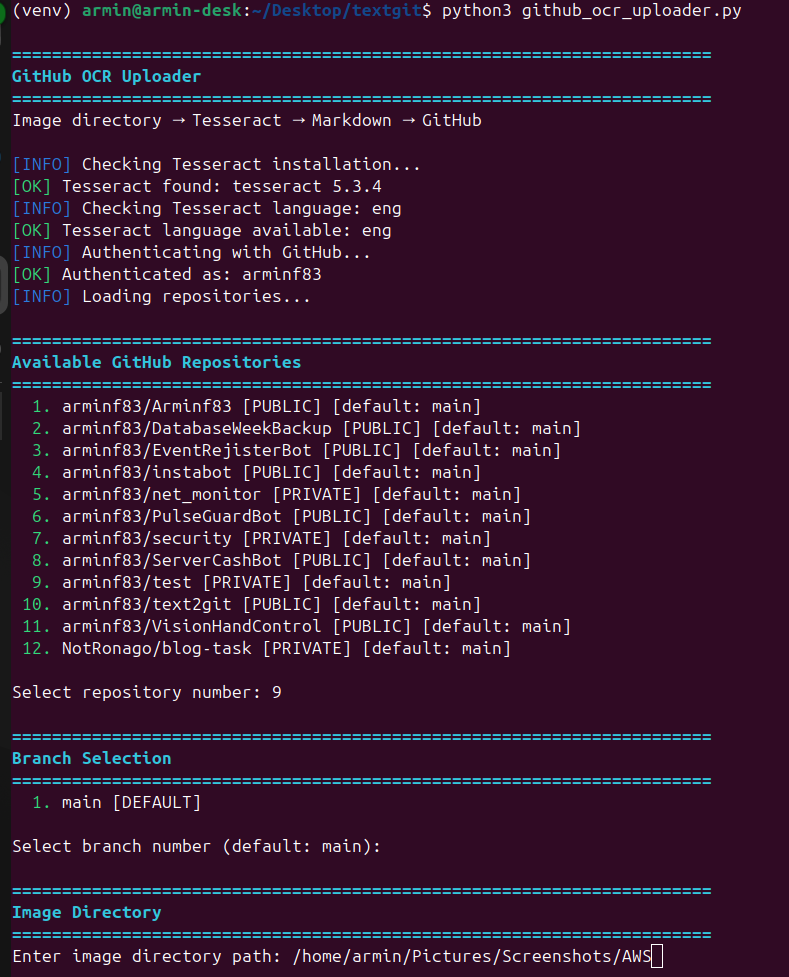
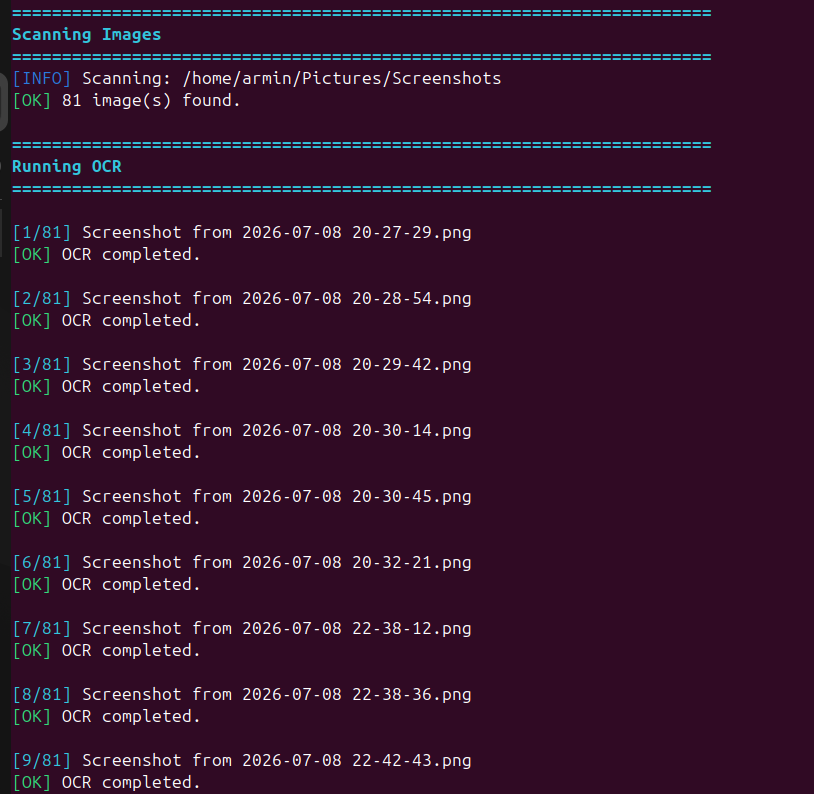
این ابزار با استفاده از Python و Tesseract OCR، تصاویر یک پوشه رو بررسی میکنه، متن داخل اونها رو استخراج میکنه و تمام نتایج رو در یک فایل Markdown جمع میکنه.
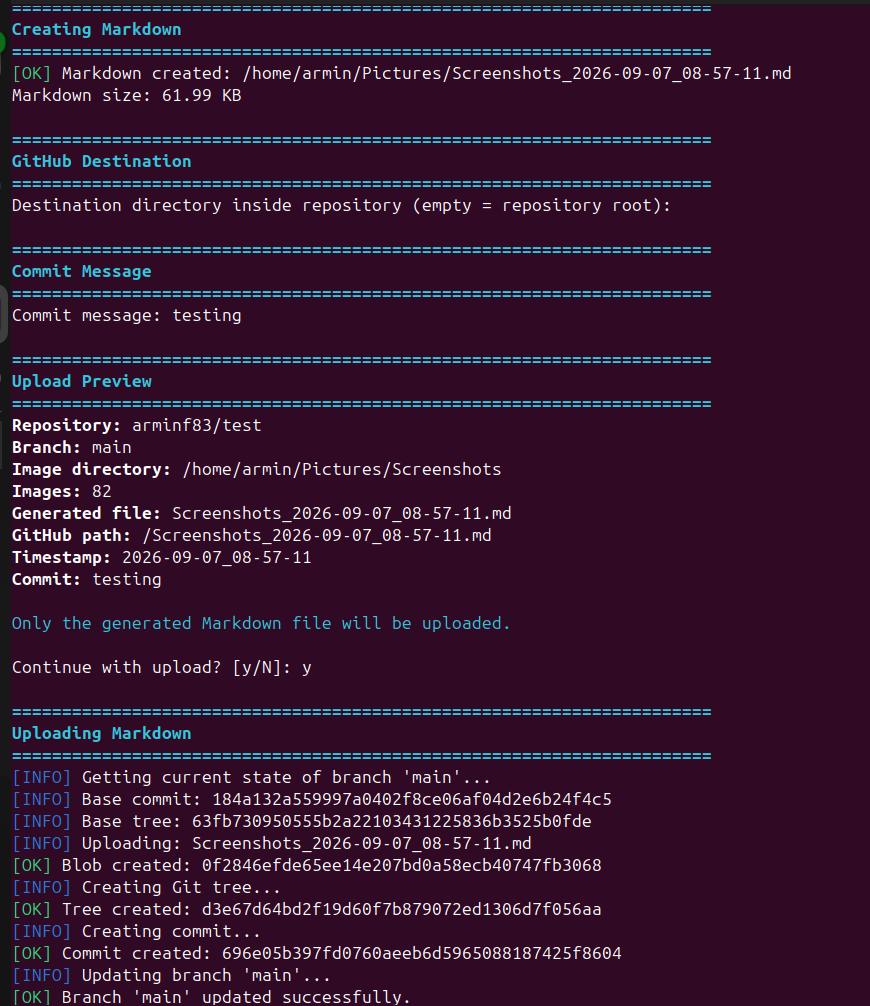
قسمت جالبتر اینجاست که خروجی فقط روی سیستم ذخیره نمیشه — این فایل مستقیم روی GitHub قرار میگیره؛ با استفاده از GitHub API یه Commit جدید ایجاد میشه و در نهایت میتونه برای جزوهنویسی و خلاصهنویسی استفاده بشه.
روند کار تقریباً اینشکلیه: Screenshot گرفتن از نکات مهم ↓ استخراج خودکار متن ↓ ساخت یک فایل Markdown ↓ انتقال مستقیم به GitHub
چی یاد گرفتم
این پروژه علاوه بر یک ابزار کاربردی، فرصتی بود برای یادگیری بیشتر دربارهی:
- Python
- OCR و Tesseract
- REST API
- GitHub API و Git Database API
- Automation
- مدیریت Secretها
این پروژه هنوز جای زیادی برای بهتر شدن داره — اگر پیشنهادی برای توسعه یا بهبودش دارید، خوشحال میشم به اشتراک بذارید.